
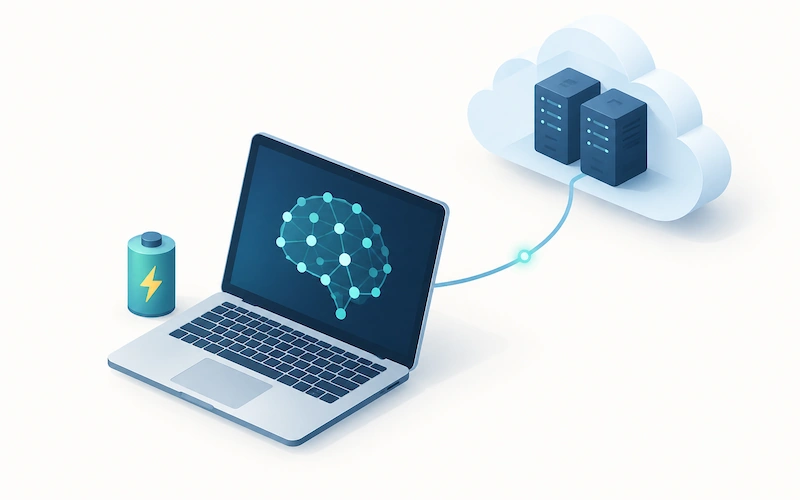
En un trabajo titulado Intelligence per Watt, unos investigadores han estudiando cuánto trabajo relacionado con los modelos de IA puede procesarse de forma efectiva en equipos convencionales, como un ordenador de sobremesa o un portátil, sin tener que irse a la meganube de Amazon o de Google. Y sugieren como métrica la inteligencia por vatio, que relaciona la la precisión de las respuestas y la potencia eléctrica media consumida. No parece mala idea.
En esa relación inteligencia/vatio cuanto más «lista» sea la IA, mejor, y cuanta menos energía y electricidad consuma, más nos quedará a los humanos «para nuestras cosas».
Meticulosas pruebas de eficiencia
Para las pruebas evaluaron más de 20 modelos, ocho plataformas de hardware (Apple M4 Max, NVIDIA B200, AMD Instinct MI300X…) convenientemente cargadas de RAM y almacenamiento que iban como pepinos y realizaron un millón de consultas (prompts) de conversación y razonamiento*. Total, ¡era gratis! Los modelos locales respondieron correctamente al 88,7% de las consultas de promedio, aunque el porcentaje de acierto dependía un poco de la temática.
Esto lo hicieron en varias ocasiones. Entre 2023 y 2025 los IPW mejoraron un factor de ×5,3, gracias a los nuevos algoritmos, modelos y el propio hardware. La proporción de consultas que podían resolverse pasó del 23,2% al 71,3%. Chips como el Apple M4 Max permiten ejecutar estos modelos con tiempos de respuesta prácticamente interactivos.
El mejor de los modelos fue de calle GPT-OSS-120B (de OpenAI) sobre un Apple M4 Max, con una IPW de 0,00418 (cuanto más alta, mejor). Los siguientes cuatro puestos los ocupan Qwen3-32B, 14B, 8B y 4B (de Alibaba) con entre 0,00197 y 0,00140. Las B por cierto significan miles de millones de parámetros (billions) del entrenamiento del modelo.
Eso sí, hay una pega: con modelos idénticos, las plataformas que están en la nube obtienen una inteligencia por vatio al menos 1,4 veces mayor. Eso quiere decir que llevarse la IA al portátil exige todavía mejorar el hardware local, y la batería de los equipos portátiles y dispositivos móviles también tendrán algo que decir al respecto, claro.
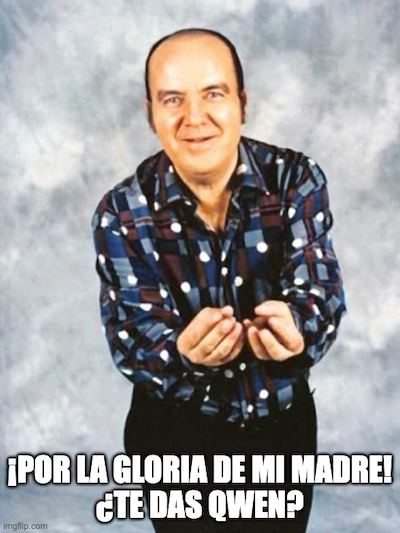
Y perdón por el chiste malo, pero es que a mí cada vez que oigo Qwen me recuerda invariablemente al gran…
_____
* Si no me fallan los cálculos, un millón de consultas a cada modelo son 8 millones en total, y el precio promedio por consulta del año pasado, según Google, eran 0,000036 euros, así que les ha salido todo el experimento por menos de 300 euros. Aprox.
Relacionados:
- Centros de datos a lo bestia: Hyperion, Terafab… Se miden en GW y TW
- El coste energético y medioambiental (y de dinerito) de las consultas a Gemini, la IA de Google
- La lista de los más listos: el análisis de la «inteligencia» de las IA
- Un comparador de modelos de Inteligencia Artificial
- Avances en las pruebas para clasificar a las IAs según su «inteligencia»
- DeepSeek: un nuevo modelo de IA especializado en razonamiento lógico, resolución de problemas y con licencia abierta MIT
- Material abierto para construir modelos de razonamiento general: 1.600.000 preguntas y 270.000 trazas de cadenas de pensamiento
- Modelos de lenguaje abiertos para una IA más transparente en Europa
- Cruce de cables: el coste energético de la vida digital
- Una inteligencia artificial capaz de abatir cazas de combate pilotados por humanos expertos