Por @Alvy — 8 de Noviembre de 2026

Cientos de chips en un banco de imágenes microscópicas para amantes de los procesadores

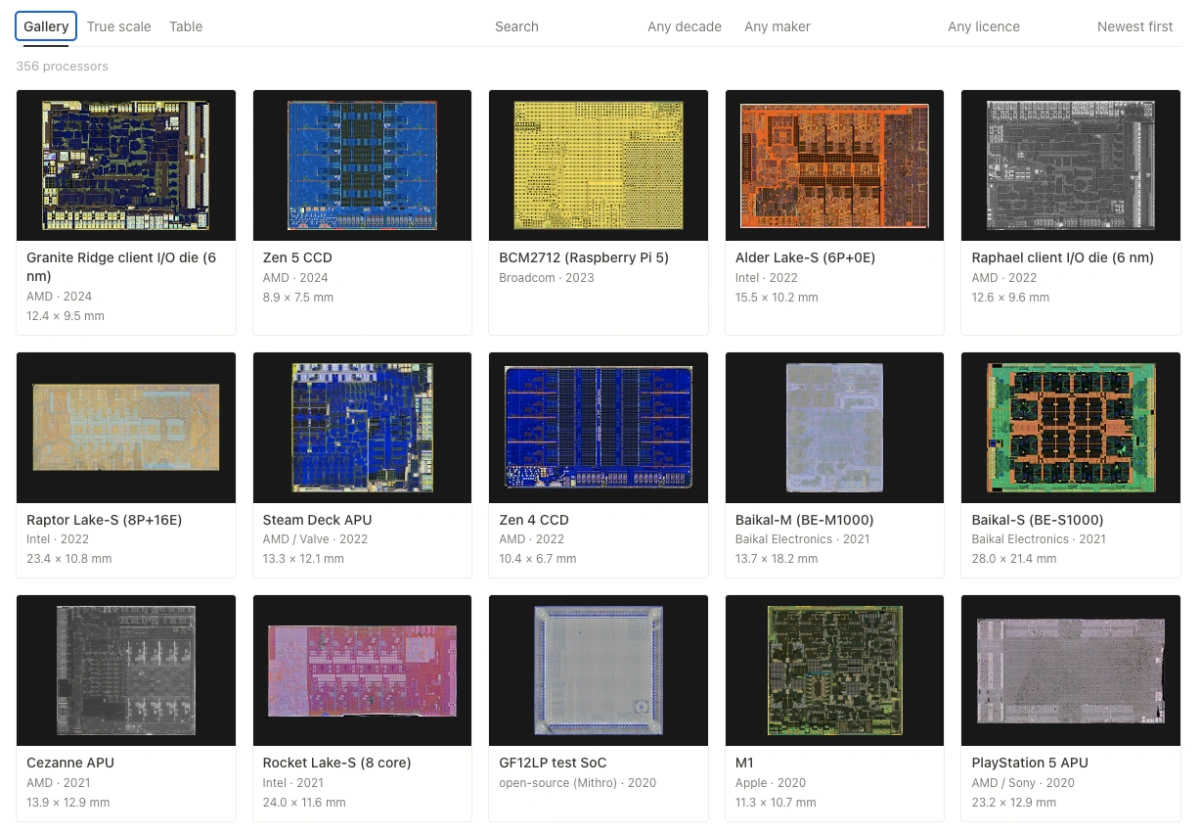
Every processor die es una colección de 356 fotografías de los circuitos integrados que se esconden dentro de otros tantos procesadores, desde 1972 hasta 2024. Son imágenes microscópicas de su interior, más concretamente la pastilla de silicio principal (en inglés, die) que normalmente está encapsulada y oculta. Detrás de esta arqueología electrónica están aficionados como Pauli Rautakorpi, Fritzchens Fritz y John McMaster, entre otros.

¿Cómo se hacen estas fotografías? Para conseguirlas hay primero que retirar cuidadosamente las capas protectoras del chip mediante abrasión o productos químicos. Luego hay que utilizar un juego de lentes macro apropiado o un microscopio; algunos de los procesadores antiguos son de varias micras (8 µm, como el mítico 6502) pero también los hay más compactos (6 nm, como en el Ryzen 5 9600X). Esa minúscula distancia se refiere al tamaño de los transistores que los componen, a veces a la distancia entre ellos.

La galería permite explorar los chips por fabricante, modelo y año, ampliarlos y consultar sus dimensiones. Ojito que hay imágenes colosales; encontré un Pentium 4 EE [debajo] de 27.500 × 16.000 píxeles, que no está nada mal. También ofrece una vista a escala real para los 114 procesadores cuyas medidas se conocen. Entre las pequeñas maravillas históricas aparecen el Intel 8008 de 1972 (4,4 × 3,2 mm), el legendario MOS 6502 de 1975 (3,1 × 2,7 mm), el Zilog Z80 de 1976 (3,5 × 3,4 mm) y el Motorola 68000 de 1979 (7,1 × 6,2 mm). También hay procesadores de consolas, ordenadores personales y servidores modernos.
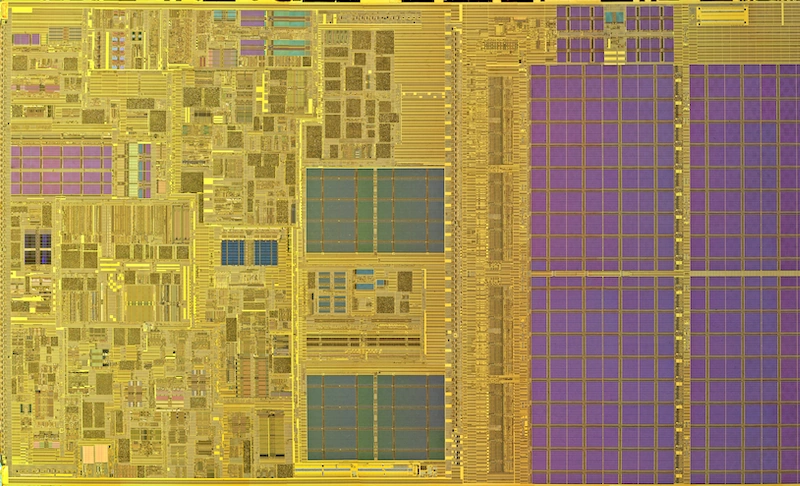
Pentium 4 EE

▼ (ampliación de la esquina superior izquierda) ▼
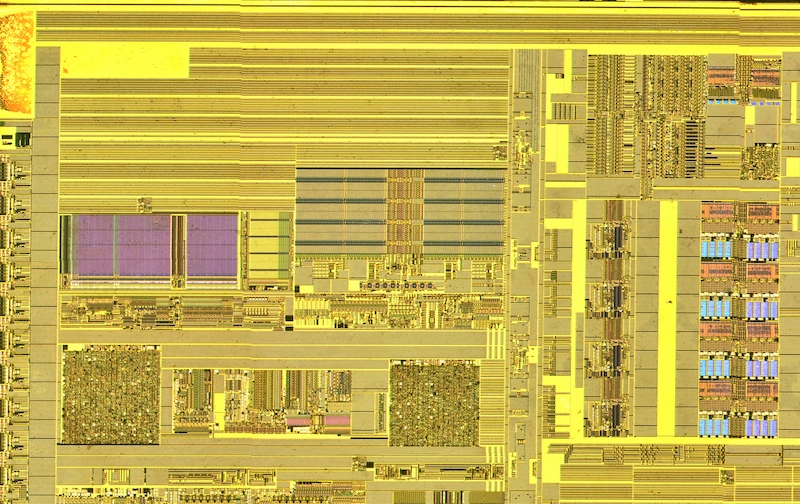
Pentium 4 EE (detalle)

Las imágenes conservan sus licencias originales, todas ellas Creative Commons de diversos tipos, y enlaces a sus autores y a las versiones completas, generalmente archivadas en la Wikipedia. La colección llega hasta los AMD Zen 5 de 2024. Una galería de lujo donde los paisajes son de silicio y los edificios que parecen componer esas ciudades en miniatura funcionan a miles de millones de ciclos por segundo.

Relacionados:

PUBLICIDAD


Por @Alvy — 8 de Noviembre de 2026

Los tokens, pequeñas unidades básicas en el mundo de la IA / Imagen: GPTEsta semana estuve en Cruce de cables (RNE), el programa de radio que acerca la tecnología a las personas, hablando de la relevancia de los tokens, esas pequeñas unidades básicas del mundo de la inteligencia artificial. Se puede escuchar en RTVE Play en streaming; y aprovecho para recordar que en directo se emite de madrugada de sábado a domingo a las 3:00am, por si te pilla despierto a esas horas.

El caso es que, desde hace algún tiempo, da la impresión de que los tokens están pasando de ser la unidad de medida del consumo de inteligencia artificial a ser «el nuevo maná digital». Son útiles, todo el mundo los desea y unos pocos elegidos, quienes más tienen, cuentan con una ventaja competitiva.

Tokens y tipos de tokens

Un token de IA es la unidad básica con la que una inteligencia artificial procesa el lenguaje. Son como los bits de las consultas y de los textos de salida. Suelen ser algo más que una letra y menos que una palabra larga o con signos de puntuación. «Hola, ¿qué tal?» puede ocupar unos siete tokens, dependiendo del modelo de lenguaje utilizado. En inglés, 1.000 tokens equivalen aproximadamente a 750 palabras (unos 3.500 ó 4.000 caracteres); en español suelen representar menos.

Además de ser un tanto imprecisos en cuanto a su capacidad para procesar el lenguaje natural, aunque útiles, existen diferentes tipos de tokens.

  • Los tokens de entrada salen del texto que se envía a la IA: preguntas, instrucciones, documentos, etc.
  • Los tokens de salida son en cambio el texto que genera la IA para responder.
  • Los tokens de entrada en caché (memoria intermedia) corresponden a información enviada anteriormente que el sistema puede reutilizar sin volver a procesarla por completo.
  • Los tokens de razonamiento los generan algunos modelos internamente para resolver problemas antes de contestar. Es como si también contabilizaran tokens cuando «piensan» para sí mismos: «voy a comprobar la hoja de cálculo y compararla con el resto de datos…»; son parecidos a los tokens de salida.
  • Los tokens multimodales representan imágenes, audio, vídeo u otros contenidos.

Cada uno de estos tipos de tokens tiene un consumo de recursos de IA y un precio. Los más comunes suelen ser los tokens de salida, y luego los de entrada (si se trabaja con documentos grandes) y razonamiento, según sean las consultas. Los de imágenes o vídeo son muy voluminosos, por el tipo de información que manejan. Los de caché suelen ser más baratos y los de salida, junto con los de razonamiento avanzado, los más caros. Es importante saber que los tokens no tienen un precio universal, y cada empresa los tarifica como quiere. Generalmente tienen tarifas por cada millón de tokens usados, según tipos, pero los usuarios no llegan ni a verla.

¿Cómo valoran los tokens las empresas como OpenAI o Anthropic en sus aplicaciones (ChatGPT o Claude, por ejemplo)?

Seguir leyendo: «Cruce de cables: Los tokens, pequeñas unidades básicas en el mundo de la IA»


PUBLICIDAD


Por @Alvy — 8 de Noviembre de 2026

Las palabras que la tecnología ha «robado» al diccionario, o cuando el correo (electrónico) se volvió más relevante que el correo (postal)

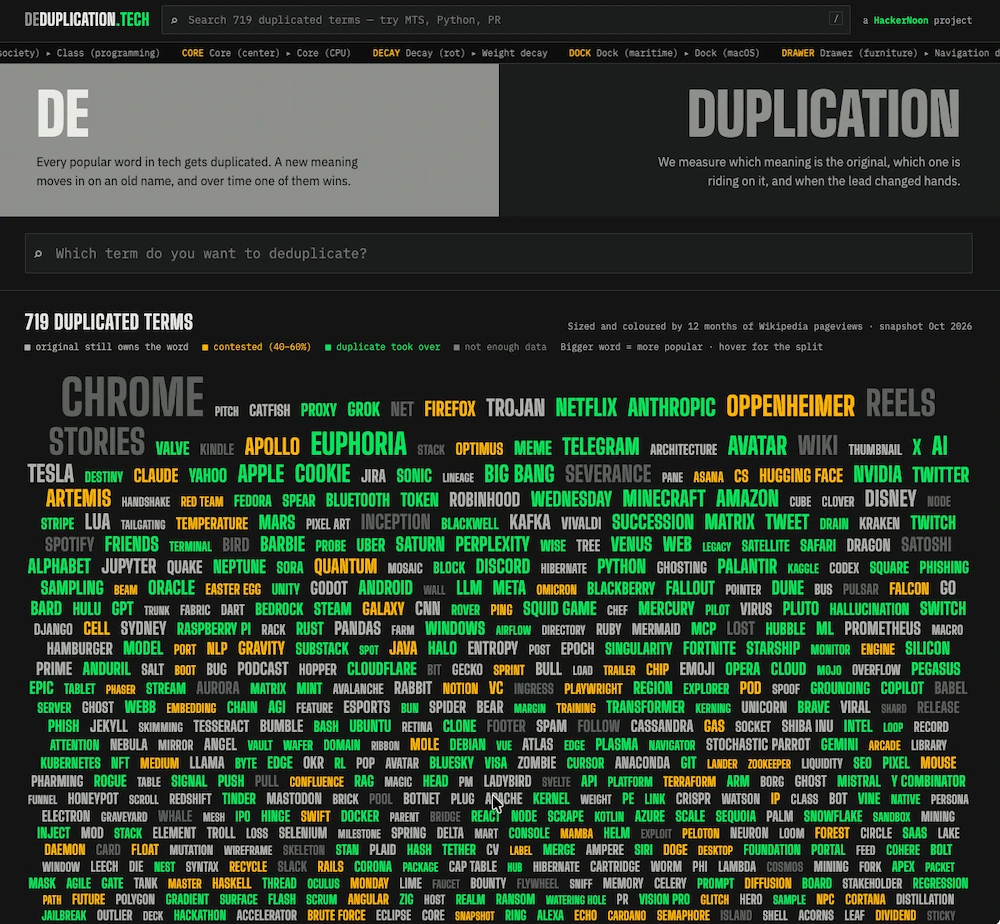
Interesante tema el de la combinación de la lingüística y la tecnología. Un buen ejemplo sería Deduplication, una lista de 719 términos tecnológicos en inglés que muestra cómo algunos términos técnicos han superado a sus equivalentes de toda la vida en las conversaciones e interés por ellos. U okupado, según se mire.

Porque la cuestión es: ¿Al hablar de «ratón» te refieres al periférico del ordenador o al animal? ¿Y «virus»? ¿«Te lo envío por correo» es «electrónico» o «postal»? ¿Buscas en Wikipedia «la nube» para aprender sobre eso que flota en el aire o te referías al concepto etéreo de las redes de servidores?

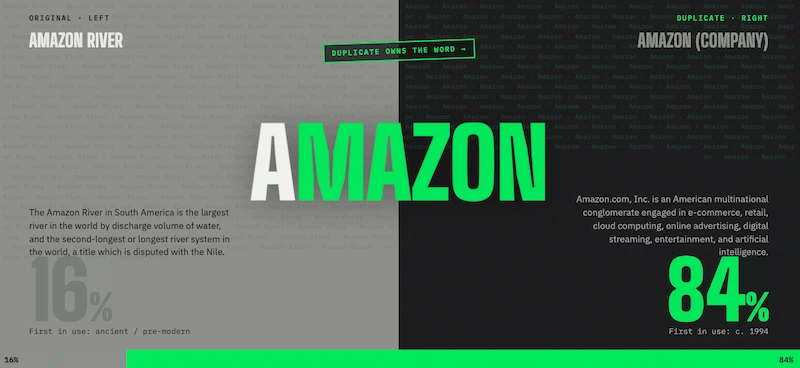
En castellano lo tenemos más fácil, porque muchos de estos términos son diferentes: Amazon no es el Amazonas, sino la empresa que vende de todo en su tienda, pero en inglés se dicen igual. Artemisa sigue siendo la diosa griega de la caza, pero en inglés puede ser Artemis, el programa espacial para volver a la Luna. Y para nosotros una manzana es una manzana, pero en inglés Apple se relaciona más con la empresa de Cupertino que con la fruta (por no hablar de Apple Records, la discográfica, ya olvidada). Aun así todavía tenemos algunas que pueden confundirnos: Avatar, Temperatura, Terminal, Macro, Ángel, Portal…

Amazonas 16% vs. Amazon 84%

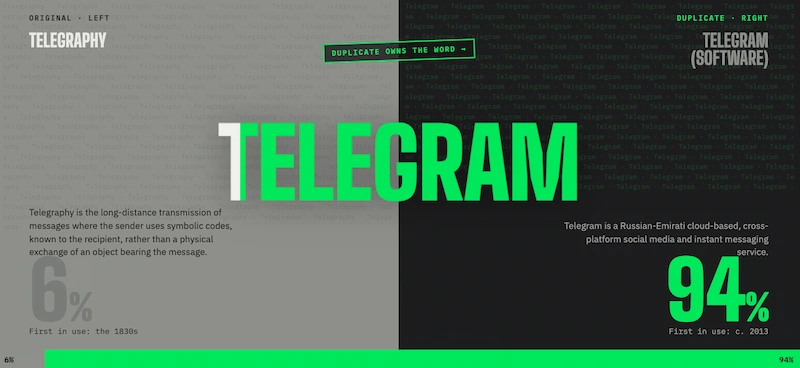
Lo que hace la lista de Deduplication es mostrar ambas acepciones y calcular cuál es más popular actualmente, mostrando en forma de gráfica las visitas a la Wikipedia de cada una de ellas, para comparar. Si alguna tiene más del 60% se declara ganadora; la otra se considerará en cierto modo condenada al ostracismo.

Hay 14 categorías en total (inteligencia artificial, cultura de internet, juegos…) Esto mismo también se podría hacer con Google (y el término que salga más arriba se declara ganador) pero tal vez la Wikipedia sea mejor indicativo. El cálculo se hace sobre las visitas a esos términos en los últimos 12 meses en la Wikipedia [en inglés], que se considera un medidor más fiable del interés que despierta entre la gente… Aunque eso ya sabemos que es un poco relativo.

Telegrama 6% vs. Telegram 94%

Naturalmente, las visitas a la Wikipedia no equivalen al uso real de una palabra: dependen del idioma, la actualidad, la curiosidad de los lectores y hasta de cómo estén organizados los artículos. Tampoco permiten saber qué significado utiliza la gente realmente en sus conversaciones cotidianas, pero algo es algo. Como experimento estadístico resulta entretenido y ofrece una forma de observar cómo cambia el lenguaje.

Los amantes del lenguaje han de saber que en esta encarnizada lucha hay algunas palabras que resisten cual aguerridos galos y todavía no han sucumbido: Jekyll (el personaje de la novela de Robert Louis Stevenson, frente al generador de páginas web estáticas), Peso (el de los objetos físicos, frente a su uso como parámetro de la IA) o Flame (ataque personal, que en castellano ha pasado a ser flamazo). ¡Enhorabuena a los agraciados!

Relacionados:


PUBLICIDAD


Por @Alvy — 7 de Noviembre de 2026

La guerra eterna del maíz: corn vs. maize (CC) freepngimg.com

Me ha hecho gracia encontrarme de nuevo con la página de discusión sobre el maíz en la Wikipedia. Tenía anotado un viejo hilo al respecto y veo que pasan los años y la cosa no ha cambiado. Es algo que demuestra por qué internet es genial y cómo en ella hay rincones donde la humanidad demuestra que podría discutir durante décadas sobre prácticamente cualquier cosa. En este caso, el debate es si el artículo dedicado al maíz debería titularse maize o corn en inglés, dos términos que parecen equivalentes en ese idioma, aunque luego se descubre que no tanto.

En castellano tenemos a veces esa misma situación, pero creo que no genera tanta discusión: podemos llamar automóviles a los coches (o incluso carros), a las cerillas fósforos o a los ordenadores computadoras. Pero no me viene a la mente ninguna lucha tan encarnizada. ¿Patata o papa? ¿Móvil o celular? ¿Gafas o anteojos? Aquí parece que la regionalidad, generalmente se refiere al uso común en España vs. Latinoamérica, aunque también podríamos hablar que si son fabes o alubias dentro de España (o entre Asturias vs. resto de España).

El caso es que la controversia del corn frente al maize para el título enciclopédico del maíz lleva abierta dos décadas. Y como en Wikipedia algunas cosas se votan, incluso hubo propuestas formales de cambio en 2007, 2011, 2013 y 2015, todas ellas sin conseguir rebautizar el artículo. Una auténtica guerra de las mazorcas, con argumentos lingüísticos, científicos y hasta acusaciones de «antiamericanismo». Buscando al respecto he visto que hasta la revista online Vice habló de ello.

«Maize» vs. «corn»

Los partidarios de maize defienden que es un término científicamente preciso e internacionalmente comprensible. Corn, en cambio, significa cosas diferentes según el país: en Inglaterra es más bien trigo, en Irlanda avena y en Estados Unidos maíz. Al igual que sucede en la versión de Wikipedia en español, la Wikipedia en inglés debe evitar favorecer una variante nacional del idioma. Una regla que suelen seguir es que la precisión importa más que la popularidad, dado que se trata de enciclopedia.

Los defensores de corn, en cambio, dicen que es el término más cotidiano, reconocible y mucho más buscado en internet, especialmente en Estados Unidos. Wikipedia recomienda utilizar nombres comunes, y a las palomitas nadie las llama popmaize sino popcorn. Los del otro bando replican que las búsquedas de corn en la Wikipedia ya redirigen automáticamente a maize.

Parece que, por ahora, maize sigue ganando. Aunque, con un poco de sarcasmo, también existen páginas en la propia Wikipedia de desambiguación para corn y para maize. En la de corn dice que «corn se refiere a menudo a maize» mientras que en la otra pone que «maize es una planta».

Una larga disputa enciclopédica en la que se han invertido probablemente más palabras que granos tiene una tonelada de mazorcas.

Relacionados:


PUBLICIDAD