Por @Alvy — 1 de Octubre de 2026

Otra IA descifra un correo de Napoleón enviado al general Marmont 217 años después
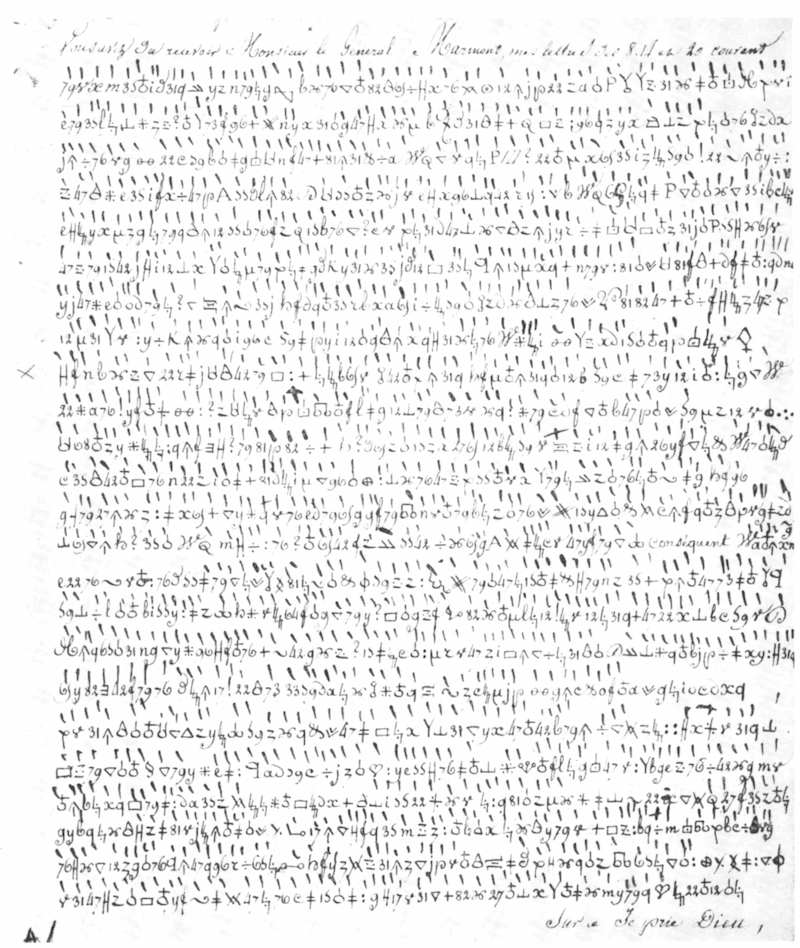
En Breaking the Marmont Cipher, Carter Church cuenta cómo GPT-6 Astra descifró una carta militar que Napoleón envió al general Marmont, fechada en marzo de 1809. Se trata de otra rotura (descifrado, técnicamente hablando) de un código antiguo mediante IA, como el reciente mensaje de Enigma que ya comentamos hace unos días. Esta vez el secreto llevaba guardado 217 años: las instrucciones napoleónicas seguían escondidas tras números, letras y símbolos manuscritos.

Según Church, hicieron falta unas seis horas de ejecución del modelo y varias tardes de un humano (suyas, vamos). En varios sitios dice que el cifrado no tan fuerte, sorprende ni difícil… Pero se había resistido hasta ahora a los ataques de los criptólogos.

Un descifrado metódico

GPT-Astra transcribió la imagen a algo más manejable con su OCR, reconstruyó un cifrado homofónico, donde una letra puede tener varios símbolos, y buscó soluciones mediante estadísticas propias del idioma francés. En total había 1.300 unidades y 155 signos distintos; de un mensaje anterior se conocían ya 435 unidades, aproximadamente el 33 por ciento (uno de cada tres). Algunos símbolos representaban palabras completas, otros no significaban nada. Eso era algo muy típico de la época, para jugar al despiste y volver locos a los criptoanalistas.

¿Qué decía Napoleón en su carta que era tan importante? La carta describe posiciones militares y el número de fuerzas, de hasta 80.000 hombres, buscando tranquilizar a Marmont antes de la guerra contra Austria. Curiosamente, la propia carta permitió corregir su datación anterior, que la situaba en 1807 porque mencionaba como fecha 1809.

Church ha publicado la clave, la transcripción y los programas para reproducir el resultado. Se conoce al completo excepto por cinco signos que tienen una interpretación desconocida, más bien dudosa, que en realidad tampoco altera el sentido general de las frases. Un historiador llamado Satoshi Tomokiyo ha revisado la solución, dándola por correcta.

Aunque Napoleón pudo guardar su secreto durante más de dos siglo, acabó cayendo ante la implacable IA.

El mensaje original

Comenzaba así:

Debe de haber recibido, señor general Marmont, mis cartas de los días 8, 14 y 20 del presente mes (…) Contenían las órdenes e instrucciones que [Su Majestad] me encargó transmitirle. Me apresuro hoy a comunicarle la posición de los ejércitos franceses y aliados. El duque de Danzig, al frente de cuarenta mil bávaros, ocupa Múnich y Passau. El príncipe Poniatowski, al frente de treinta mil polacos, está acampado junto al Vístula, amenazando Cracovia. El príncipe de Ponte-Corvo comanda el ejército sajón, acampado delante de Dresde; el duque de Auerstaedt ocupa Bayreuth con ochenta mil franceses, y el duque de Rivoli manda sesenta mil hombres acantonados en Ulm y Donauwörth. El [general] Oudinot, con el cuerpo de élite de cuarenta mil hombres, se encuentra en Augsburgo y junto al Lech (…)

Relacionados:


PUBLICIDAD


Por @Alvy — 1 de Octubre de 2026

Cómo usar datos públicos sin tener que jugar a la búsqueda del tesoro: un catálogo libre para aprovecharlos de verdad

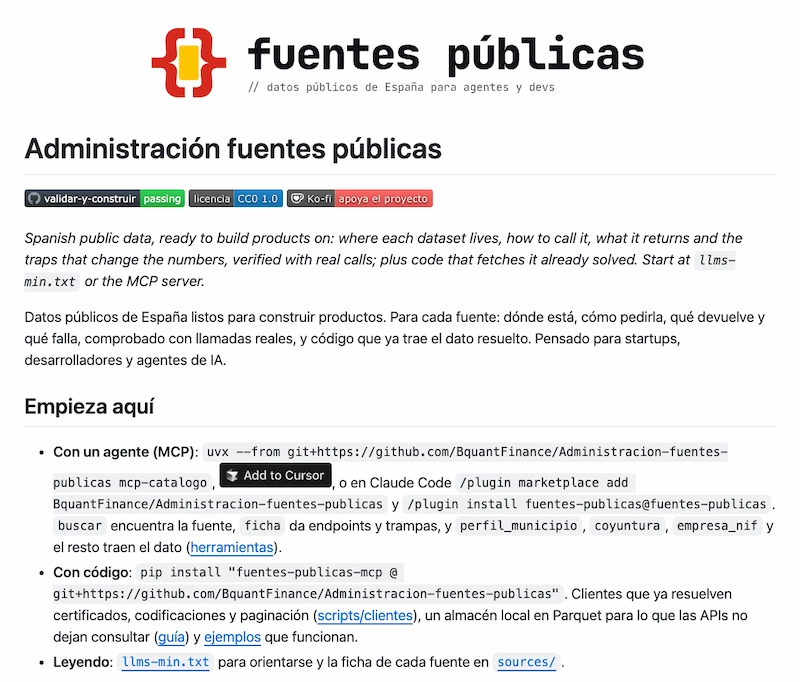
El proyecto que se le ha ocurrido a Gerard Sánchez (de BQuant Finance) es de esos que merecen la alabanza generalizada. Se llama fuentes públicas y reúne algo que debería resultar mucho más fácil de encontrar de lo que en realidad es: instrucciones y código para aprovechar los datos públicos y abiertos españoles. Deberían ponerle un enlace en la página de datos abiertos de administracion.gob.es y en cada una de las autonómicas, locales y sectoriales.

El catálogo está en Github e incluye 95 fuentes, desde estadísticas del INE hasta medicamentos, carburantes, subvenciones, mapas y contratación pública. Cada ficha explica dónde consultar los datos, cómo solicitarlos, qué devuelve el servidor y –atención, que aquí viene lo bueno– qué trampas conviene evitar. Incluye ejemplos comprobados, código en Python y además un servidor MCP para que los agentes de inteligencia artificial puedan consultar esas fuentes. GPT, Claude y los demás lo agradecerán.

Lo mejor es sin duda lo de los detalles que faltan en la documentación oficial. Dos ejemplos reales recogidos en el repositorio:

  • La exportación de la Base de Datos Nacional de Subvenciones devuelve solo 50 filas si no se especifica el tamaño de página, aunque existan miles, y no avisa del recorte. ¿Acaso lo hacen por malicia o por desconocimiento?
  • Madrid figura con el código 28:900 en SIGPAC y Catastro, en lugar del código INE 28079 que sería como dios manda. Algo raro que te podría hacer perder horas investigando por qué peta tu código. Para resolverlo, el proyecto proporciona una tabla de equivalencias para los 8.132 municipios españoles. ¿Por qué no hacen eso mismo las entidades oficiales?

El proyecto también resuelve problemas de certificados seguros, codificaciones y paginación, que pueden convertir una consulta «aparentemente correcta» en una colección de cifras incompletas, sin que nadie se de cuenta o se quede pensando en modo WTF durante horas. Además, todo se verifica cada semana con GitHub Actions, así que se mantiene actualizado y funcional.

Libre como el Sol cuando amanece

Fuentes públicas es, además, software libre: el código, el catálogo y la documentación se publican bajo CC0 1.0, que básicamente sería «úsalo como quieras, pero recuerda que un gran poder conlleva una gran responsabilidad». Se puede usar para aprender, usar, modificar, compartir e incorporar a cualquier proyecto, incluidos los comerciales. Eso sí: los datos de extraigas de cada organismo conservarán sus propias condiciones de reutilización. En definitiva: libre como el sol de Nino Bravo, pero… respetando la leyes de la termodinámica.

Entre los ejemplos disponibles en el repositorio hay un buscador de gasolineras cercanas, consultas del BOE y también avisos de nuevas licitaciones por sector, provincia u organismo contratante. Un buen comienzo para ir investigando cómo funciona.

(Vía @Gsnchez que tiene una página de aportaciones en Ko-fi.)

Relacionados:


PUBLICIDAD


Por @Wicho — 1 de Octubre de 2026

Aunque las previsiones meteorológicas eran sólo favorables en un 40 % al final la tripulación Crew 13 de la NASA ha podido despegar a bordo de la Crew Dragon Grace de SpaceX rumbo a la Estación Espacial Internacional (EEI). El lanzamiento estaba originalmente previsto para el 12 de septiembre, pero una fuga en el depósito de oxidante de la cápsula obligó a posponerlo hasta hoy.

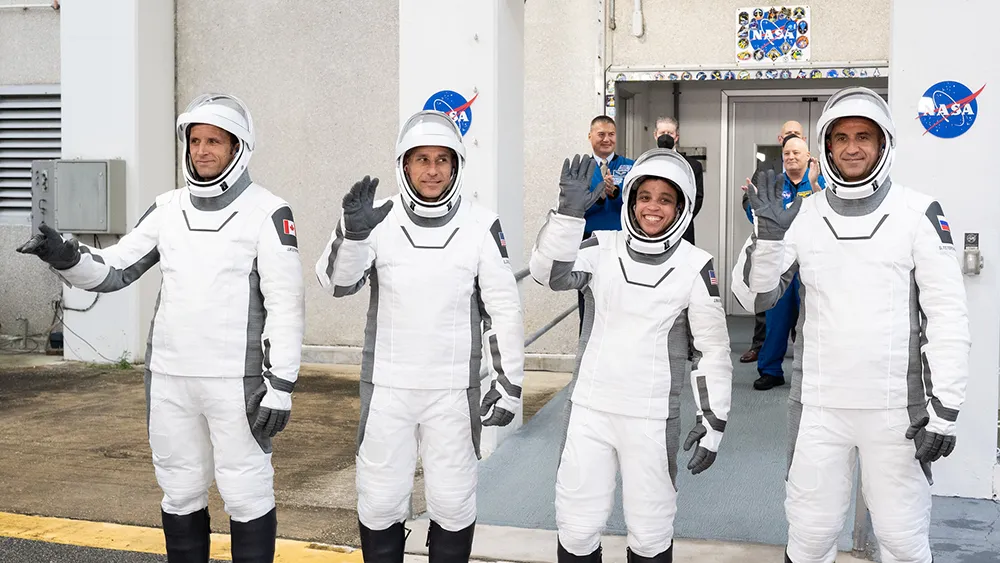
Está formada por los astronautas de la NASA Jessica Watkins y Luke Delaney, el astronauta de la Agencia Espacial Canadiense (CSA) Joshua Kutryk y Sergey Teteryatnikov de Roscosmos.

Los cuatro frente a la salida del edificio en el que se ponen los trajes, ya vestidos con ellos
De izquierda a derecha Kutryk, Delaney, Watkins y Teteryatnikov saludan antes de dirigirse a la plataforma de lanzamiento – NASA

Además de las tareas que van a llevar a cabo a bordo de la Estación también van a dar relevo a la tripulación Crew 12, que lleva en la EEI desde el pasado 14 de febrero y tiene previsto su regreso a casa el próximo día 5.

Si todo va según lo previsto Grace atracará en el puerto frontal del módulo Unity de la Estación esta próxima madrugada a eso de la una, hora peninsular española (UTC +2), tras un viaje de siete horas y 50 minutos. Permanecerán a bordo hasta marzo de 2027.

La primera etapa del Falcon 9 que lanzó la misión es la B1101. Volaba por tercera vez y tras cumplir con su cometido aterrizó en la Zona de aterrizaje 40, lista para ser revisada y volver a volar. Para Grace, que es la quinta y última Crew Dragon que está previsto fabricar, es su segunda misión tras estrenarse con la misión privada Axiom-4, también a la EEI.

Relacionado,


PUBLICIDAD


Por @Alvy — 30 de Septiembre de 2026

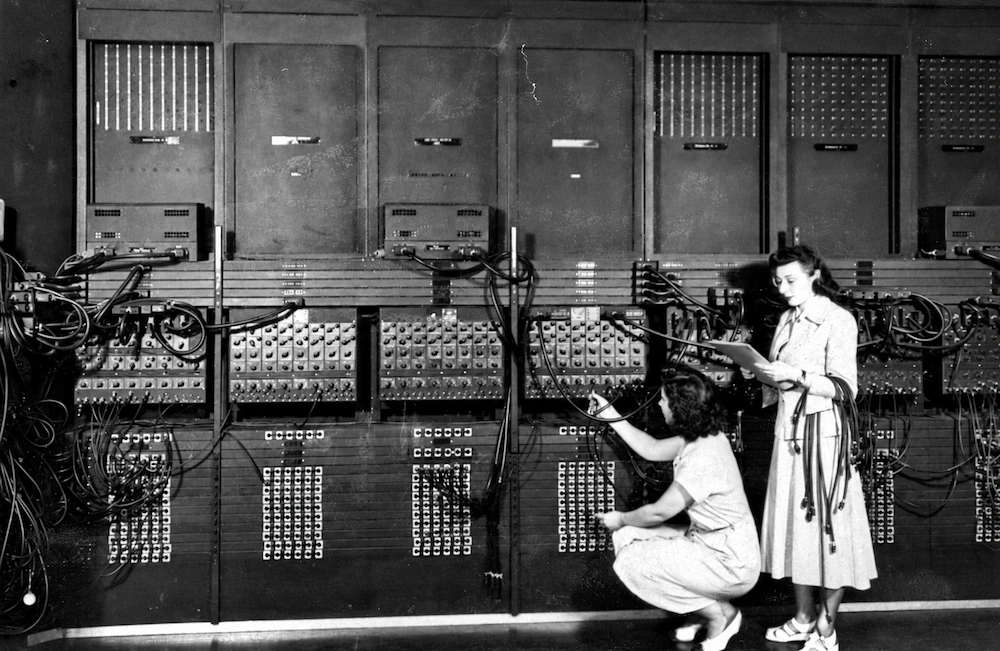
Programación del ENIAC / Marlyn Wescoff (de pie) y Ruth Lichterman (en cuclillas) Foto: (DP) ARL Technical Library

A quien le guste la relación entre la prehistoria de los ordenadores y los números aleatorios le encantará echar un vistazo a Los Alamos Bets on ENIAC: Nuclear Monte Carlo Simulations, 1947–1948 [PDF] publicado en la revista IEEE Annals of the History of Computing en 2014. En el artículo se relata cómo John von Neumann, Klara Dan von Neumann, Nick Metropolis y otros utilizaron el ENIAC, el «primer ordenador moderno de la historia» para ejecutar en abril de 1948 la primera simulación de Montecarlo informatizada.

El objetivo era bastante menos inocente que calcular el valor de π o hacer cálculos meteorológicos. Era calcular mediante probabilidades lo que sucedía con miles de neutrones para estudiar reacciones nucleares y, en particular, diferentes diseños de armas atómicas.

Una idea random, pero interesante

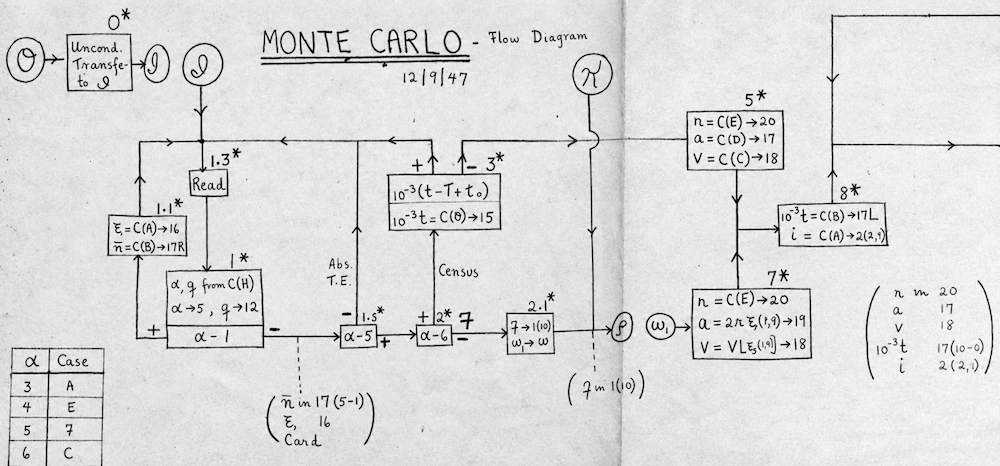
Esquema del método de Montecarlo utilizado en el ENIAC

La idea consistía en seguir neutrones virtuales y decidir gracias a los números pseudoaleatorios si se dispersaban, eran absorbidos, escapaban o producían la fisión. Si había fisión aparecían nuevos neutrones y «la fiesta continuaba».

Para generar esos números necesarios para el método de Montecarlo (en este versión, porque el método puede implementarse de muchas formas), Von Neumann utilizó el famoso método del medio del cuadrado que había inventado él mismo: tomar un número de ocho o diez cifras, elevarlo al cuadrado y quedarse con las cifras centrales. El resultado es más o menos random, aunque es sabido que resulta inadecuado para muchos propósitos. El caso es que aquí era suficiente. El generador se convirtió en una subrutina reutilizable, que según cuentan en el artículo podría ser la primera subrutina ejecutada en un ordenador, aproximadamente un año antes que las del EDSAC.

El primer intento duró diez días de dieciséis horas, aunque el ENIAC sólo produjo resultados la mitad del tiempo, principalmente por problemas de hardware. Completó 160 ciclos de 100 tarjetas perforadas sobre siete problemas y produjo a su vez más de 20.000 tarjetas perforadas. Von Neumann calificó el método un poco a lo Elon Musk: «éxito al cien por cien». En esta primera versión, parte del proceso consistía literalmente en clasificar, duplicar, eliminar y volver a introducir tarjetas perforadas que representaban neutrones.

El segundo intento ya incluyó cálculos de armas reales, como un núcleo de hidruro de uranio y una configuración llamada Zebra. Pero un error obligó a repetir uno de los cálculos. El llamado Problema número 4, relacionado con el hidruro, estaba mal planteado. El mismísimo Stanislaw Ulam escribió a Von Neumann escuetamente diciendo que «el Problema número 4 ha de repetirse, Nick ha encontrado un fallo».

El programa y su programadora

Klara Von NeumannEs aquí donde aparece Klara Dan von Neumann, la esposa de Von Neumann, cuyo papel como programadora estuvo bastante eclipsado durante décadas. Tenía 35 años y una formación matemática formal bastante limitada, pero terminó programando, operando y documentando las simulaciones. El paper la sitúa como una figura central del proyecto y atribuye a su mano buena parte del código conservado.

El programa del ENIAC resulta especialmente interesante porque ya tenía buena parte de lo que hoy consideraríamos básicamente programación: saltos condicionales, bucles, índices, instrucciones, subrutinas y los datos en un mismo espacio de direcciones. La idea original era hacer los cálculos en unos 81 pasos (recuperar dato, hacer un cálculo, guardar dato…) Todavía se conserva una versión completa con unas 840 instrucciones, codificadas en 2.208 dígitos y documentadas en 28 páginas manuscritas; demuestran las buenas costumbres las de la época. Todo ello para una máquina que necesitaba una habitación especial, pesaba toneladas y todavía necesitaba tarjetas perforadas, tiene mérito.

_____
Foto: Programación del ENIAC (DP) ARL Technical Library @ Picryl.

Relacionados:


PUBLICIDAD